はじめに
OSSやソフトウェアの既知脆弱性への対応を求められたとき、どこから検討すればよいでしょうか。
2026年10月、Webアプリケーションなどで広く利用されているPHPの実行環境に重大な脆弱性が公表され、国内でも予防的なWebサイトの一時停止や緊急点検が行われました。
また、国内組織への不正アクセスによる情報漏えいも相次いでおり、JPCERT/CCから注意喚起が公表されるなど、セキュリティ対策の重要性が改めて注目されています。
こうした状況の中、システム開発では、利用しているOSSやライブラリに既知の脆弱性が含まれていないかを把握し、適切に対応することが求められます。しかし、リリース時点で問題がなかったとしても、その後に新たな脆弱性が公表される可能性があります。そのため、デプロイ前の確認だけでなく、稼働後も継続して脆弱性を検知し、対応状況を管理する仕組みが必要です。
本記事では、顧客からのセキュリティ要件をきっかけに、Amazon Inspectorを採用した理由から、デプロイ前の脆弱性スキャン、稼働後の継続スキャン、検知後の対応を管理する運用フローまで、検討・設計した内容をご紹介します。
▼対象読者
- CI/CDに脆弱性スキャンを組み込み、運用自動化(通知・管理)を検討しているエンジニア
- サードパーティ製ツールとAWSネイティブサービス(Inspector)の選定に悩んでいるアーキテクト
- 脆弱性検知後の「例外管理」や「棚卸し」の仕組みを模索している運用担当者
▼取り扱わないこと
- AWS各サービス(VPC、IAMなど)の基本的な構築手順
- 特定のCVE(共通脆弱性識別子)に対する具体的な修正コード
- 実運用開始後の長期的な運用実績(今回はデプロイ前の運用設計と技術検証プロセスに焦点を当てます)
※本記事の検証結果は2026年8月31日までに確認した内容に基づいています。AWSサービスの仕様については、2026年11月9日時点の公式ドキュメントを参照しています。
本対応が必要になった背景
検討することになったきっかけは、顧客からAWS上で本番稼働しているシステムのサイバーセキュリティ対策に関する相談を受けたことでした。その中に、採用するOSSや市販ソフトウェアの既知脆弱性を調査し、侵入や不正操作の入口となるリスクを抑える、という要件がありました。
この要件を受け、まずソフトウェアの構成要素を把握するためのSBOMを手掛かりに、AWSで利用できる対応方法を調べました。その中で候補となったのがAmazon Inspectorです。
最初からスキャン方式や運用全体を決めていたわけではありません。Inspectorで何を確認できるのかを調べながら、要件を満たすために必要な処理を整理していきました。
なぜAmazon Inspectorにしたのか
脆弱性スキャンを自動化するにあたり、最初に直面したのが「どのツールを採用するか」という問題でした。
要件を満たすだけであれば、例えばPython環境ならデプロイ前にCI/CD上で pip-audit などを実行すれば、依存関係のチェックは可能です。また、コンテナイメージのスキャンであれば Trivy などのOSSツールも存在します。 今回はこれらを網羅的に比較したわけではありません。AWSを中心とした構成で、デプロイ前と稼働後の両方を一続きの運用として扱えるかを優先し、まずAmazon Inspectorで要件を満たせるかを検証しました。足りない機能があれば外部ツールで補完する、という進め方です。
採用判断で重視したのは、次の3点です。
- ツールの運用・保守コストの削減
外部のツールやライブラリを新たに導入すると、「そのツール自体のバージョンアップ」「実行基盤のサーバー保守」「ライセンス管理」といった運用コストが新たに発生します。対象システムがAWSを中心に構成されている場合、マネージドサービスであるInspectorを利用することで、これらの管理オーバーヘッドを手放すことができます。 - 「デプロイ前」と「稼働後」の管理統合
Inspectorには、CI/CDに組み込んでデプロイ前にSBOMを生成・検査する仕組み(Amazon Inspector SBOM Generator / Scan API)と、デプロイ済みのリソース(ECRやLambdaなど)を継続的に評価する仕組みの両方が備わっています。 - 他AWSサービスとの親和性
検知した結果(Findings)をAmazon EventBridgeでフックし、SNSやAmazon Q Developer in chat applications(Amazon Q Developer)を経由してSlackへ通知したり、Lambdaを介して管理票(スプレッドシート等)へ自動転記したりするフローを容易に実装できます。
機能要件を満たしつつ、運用時に増える管理対象を抑えられるかという観点でAmazon Inspectorを採用しました。
デプロイ前スキャンと継続スキャンの役割
Amazon Inspectorを使った構成を考えるうえで、まず整理したのが「いつ脆弱性を確認するか」です。
今回は、リリース前に問題がないかを確認するデプロイ前スキャンと、稼働後に新たに公表された脆弱性を追跡する継続スキャンの2つに分けて考えました。
- デプロイ前スキャン:アプリケーションやコンテナイメージを本番環境へ反映する「前」に実施する、いわば出荷前検査です。
- 継続スキャン:稼働を開始した「後」に、新たに公表された脆弱性を継続的に監視する仕組みです。
デプロイ前は「高リスクの未承認脆弱性が残っているか」を明示的に判定し、残っていればビルドを失敗させます。問題がなければデプロイへ進み、稼働後はAmazon Inspectorで継続的に追跡します。
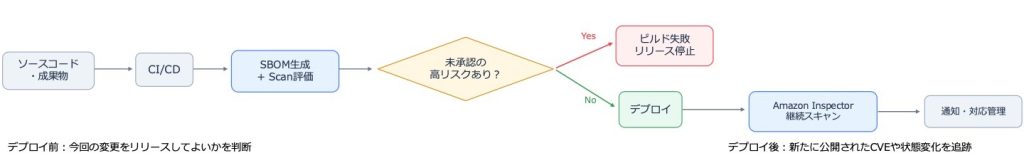
このモデルに基づき、CodeBuildなどのデプロイシェル内に「Docker build → SBOM生成 → Scan API判定 → 問題なければECRへPush」という流れを実装することで、入り口の防御を固めています。
※ECRの継続スキャンでは、イメージのプッシュ日時や最終使用日時、再スキャン対象期間の設定によって監視対象が決まります。そのため、継続スキャンを有効化しただけで、すべてのイメージが無期限に監視されるわけではありません。
コスト最適化:対象環境を「develop」と「prod」に絞る戦略
継続スキャンは効果的ですが、運用上の注意点があります。それはリソース数に応じたコストの増加です。
Lambda関数の継続スキャンは、対象となる関数に比例して料金が発生します。 ECRは初回スキャン数と再スキャン回数に応じて料金が発生します。開発(develop)、統合(integration)、ステージング(staging)、本番(prod)といった複数の環境すべてでInspectorを有効化すると、スキャン費用が想定以上に膨らむリスクがありました。
参考:Amazon Inspectorで発生する主なコスト(東京リージョン)
| 対象 | 主な課金要素 |
| Lambda | 0.36USD/関数・月 ※標準スキャン ※過去90日間に実行・更新のない関数は対象外 |
| ECR | 0.11USD/イメージ・初回スキャン 0.01USD/イメージ・再スキャン |
| EC2 | 1.512USD/インスタンス・月 ※SSMエージェントを導入している場合 |
| デプロイ前スキャン | 0.03USD/スキャン |
そこで今回のアーキテクチャでは、継続スキャンの対象を「develop環境」と「prod(本番)環境」の2つのみに絞る設計としています。
- prod環境:本番稼働中のリソースに新しい脆弱性が公表された場合、早期に把握するための監視対象
- develop環境:developブランチへマージした時点からprod反映までの間に新たに公表された脆弱性を継続的に検知するための監視対象
デプロイ前スキャンは、その実行時点で既知の脆弱性が含まれていないかを確認するものです。しかし、developブランチへマージした時点で問題がなくても、prod反映までの間に新たな脆弱性が公表される可能性があります。そこでdevelop環境にも継続スキャンを有効化し、この期間に発生した脆弱性を早い段階で検知できるようにしています。これにより、本番反映直前になって初めて脆弱性へ気づき、急遽修正やリリース判断が必要になる状況を防ぎやすくなります。
この2つの環境をカバーすることで、「本番リスクの検知」と「対応策の事前テスト」という要件を十分に満たすことができます。
デプロイ前スキャンにおける「例外管理」の実装
なぜ例外判定が必要なのか
CriticalやHighの脆弱性が検知されたからといって、必ずしも現在の実装や利用状況に影響するとは限りません。影響調査の結果、即時対応が必要ではないと判断できるケースもあります。
このような脆弱性も重大度だけで一律にリリース停止とすると、進行中の開発やリリース作業よりも脆弱性対応を常に優先することになり、作業計画への影響が大きくなります。そこで、検知後に影響を調査して対応優先度を決め、即時対応が不要と判断したものは期限付きの例外として扱い、現在進めている作業を継続できる運用ルールとしました。
この運用をCI/CDのリリースゲートにも反映するため、CriticalやHighを単純に一律停止するのではなく、承認済みで有効期限内の例外を判定に取り込む仕組みが必要になりました。
InspectorScanステージで検証
リリースゲートの実装方法として、まずCodePipelineのInspectorScanステージを検証しました。重大度ごとに件数の閾値を設定し、CriticalやHighが一定件数以上なら後続処理へ進ませない、といった固定ルールを設定できます。
単純な重大度基準だけで止めるなら、判定スクリプトを持たずに導入できるためシンプルに実装できます。しかし、今回は例外として承認したCVEと有効期限を管理し、スキャン結果と照合したうえで、有効期限内であればリリースを許可し、期限を過ぎた場合は再びリリースゲートの対象へ戻す仕組みが必要でした。
検証でつまずいたポイント:例外管理の仕組みは標準設定だけでは実現できなかった
InspectorScanステージでは、重大度ごとの固定閾値によるリリース判定はできます。一方、今回必要だった「例外ファイルを読み込む」「スキャン結果とCVEを照合する」「有効期限を確認する」「期限切れの例外を再び判定対象へ戻す」といった一連の処理は、標準設定だけでは表現できませんでした。そこで、SBOM生成・Scan API評価・例外照合をCodeBuild内のシェル処理でまとめて実行する方針へ切り替えました。
処理は次の順序です。
1. コンテナイメージなどからSBOMを生成する
2. Scan APIでSBOMを評価し、脆弱性レポートを取得する
3. 設定した重大度以上の脆弱性を抽出する
4. 例外ファイルを読み込み、CVEと有効期限を照合する
5. 未承認または期限切れの脆弱性が残っていれば、ビルドを失敗させる
InspectorScanステージとCodeBuild実装の使い分け
| 判定内容 | InspectorScanステージ | CodeBuild内の判定処理 |
| 導入方法 | 設定中心で容易 | スクリプト実装が必要 |
| 重大度ごとの固定閾値で停止 | 可能 | 可能 |
| 例外ファイルとの照合 | 標準設定だけでは難しい | 可能 |
| 有効期限に応じた例外の失効 | 標準設定だけでは難しい | 可能 |
| 独自の判定・出力形式 | 制約あり | 実装可能 |
期限付き例外をコード管理する
例外は脆弱性を恒久的に無視するための設定ではなく、「現時点では一時的に許容するが、期限が来たら再評価する」ための判断として扱います。例外ファイルには、少なくともCVE、理由、対応チケット、再評価日を持たせます。
例外ファイルの例
{
  "exceptions": [
    {
      "cve_id": "CVE-XXXX-XXXXX",
      "reason": "該当パッケージの脆弱な関数はシステム上で呼び出しておらず、攻撃経路が存在しないため",
      "ticket_id": "SEC-1234",
      "reevaluation_date": "20XX-12-31"
    }
  ]
}
上記のように例外ファイルへ理由や再評価日を記録することで、開発側でも例外として扱う根拠を確認できます。また、CodeBuildでは、スキャン結果と例外ファイルを照合し、有効期限内の例外を判定対象から除外することができます。一方、有効期限を過ぎた例外は再び判定対象として扱います。
判定ログを残して止まった理由を追えるようにする
この集計結果は、CodeBuildが自動で生成するものではありません。今回は、CodeBuild内のシェルから呼び出すPythonスクリプトで、Inspectorのスキャン結果と例外ファイルを照合し、集計した件数を標準のloggingモジュールで出力しています。CodeBuildは実行したコマンドの標準出力・標準エラー出力をビルドログに取り込むため、このメッセージを表示するための特別な追加設定は不要です。
例えば、例外適用後もCriticalやHighが残っていれば、次のようなログで停止理由と件数を確認できます。
Evaluating Inspector Scan results...
Inspector exceptions: active=1 expired=1
ERROR Inspector scan failed: DeploymentBlocked: Critical/High vulnerabilities detected; deployment stopped
Vulnerabilities after exceptions:
critical=1 high=19 medium=11 low=2 total=33
[ERROR] critical=1 reached failure threshold=1
[ERROR] high=19 reached failure threshold=1
INFO s3://{bucket_name}/inspector-result/20261106T055828511755Z/sbom_results.json
有効期限内の例外として除外した脆弱性は、重大度別の件数には含めません。有効期限を過ぎたものは再び判定対象となり、CriticalまたはHighが1件でも残っていれば、スクリプトを異常終了させて後続のデプロイを停止します。
スキャン結果の詳細をすべてログへ出すと、出力量が増え、停止理由を探しにくくなります。そこで、ログには件数と停止理由を残し、詳細結果はJSON形式でS3へ保存する構成にしました。ログ量を抑えながら、必要な情報の抽出や過去の結果との比較をしやすくしています。保存先のS3パスもログへ出力し、詳細調査につなげられるようにしています。
※結果のJSONファイルへの出力とS3への保存は、別途スクリプトで実装しています。S3への保存には、CodeBuildのサービスロールに保存先への書き込み権限(s3:PutObject)が必要です。
継続スキャンの運用:通知から「管理票」への連携と棚卸し
継続スキャンにおいても「検知して終わり」ではなく、その後の通知・対応方針までを設計する必要があります。単にチャットツールへアラートを流すだけでは、誰が調査しているのか、いつまでに対応するのかが曖昧になってしまいます。
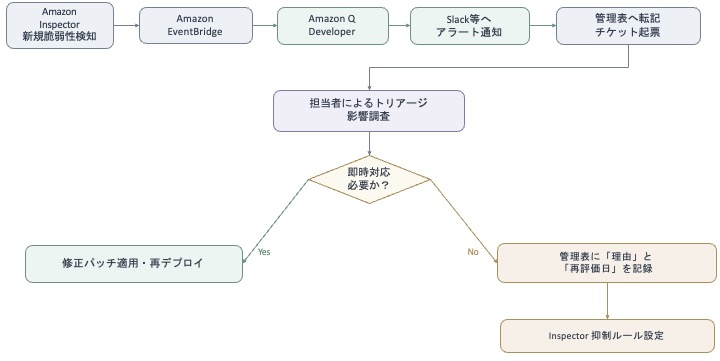
そこで、EventBridgeでInspectorの検知イベントを受け取り、以下の2系統へ分岐させる運用フローを設計しました。
- 即時検知(Slack等への通知):担当チームが検知に素早く気付くための窓口。
- 証跡・状況管理(スプレッドシート等の管理票へ転記):脆弱性ID、対象リソース、重大度を一覧化する台帳。
管理票による一元管理と「再評価日」の活用
管理票には転記されたデータに加え、「担当者」「調査結果」「対応方針」「再評価日」を入力するカラムを設けます。 継続スキャンで検知された脆弱性に対しても、即時対応が不要の場合はInspectorの「抑制ルール(Suppression Rules)」を利用して一時的にアラートを抑止しますが、同時に管理票上で「再評価日」を設定します。
この運用により、定期的なセキュリティ定例会議などで「期限を過ぎた例外」「長期間更新されていない検知結果」をチーム全体で棚卸しすることができ、脆弱性対応の漏れや放置を仕組みとして防ぐことができます。
おわりに
脆弱性対策はツールを導入するだけではなく、運用ルールまで決める必要があります。「なぜそのツールを使うのか」という背景の整理から始まり、「デプロイ前と後のスキャン設計」「環境ごとのコストコントロール」そして「放置を防ぐ例外管理の運用フロー」までをセットで設計することが重要です。
今回の運用設計をする際に実施した検証では、固定閾値のInspectorScanステージだけでは期限付き例外を扱いにくく、CodeBuild側に判定ロジックを持たせる必要があることが分かりました。次の段階では、実運用で発生する例外件数や通知量、担当者間の運用負荷を見ながら、ルールを継続的に調整していくことになります。実運用を開始した後には、また新たな運用課題が見えてくるはずです。それらについては、後編の記事として追ってご紹介できればと思います。
参考文献
- PHPの脆弱性対策について(CVE-2026-109618、CVE-2026-109619:PHP2shell)
- 直近で相次いでいる国内組織における不正アクセスに関する注意喚起
- Amazon Inspector スキャンを CI/CD パイプラインに統合する
- Amazon Inspector SBOM Generator
- Amazon Inspector による Amazon Elastic Container Registry コンテナイメージのスキャン
- Amazon Inspector を使用した AWS Lambda 関数のスキャン
- Amazon Inspector による Amazon EC2 インスタンスのスキャン
- Amazon Inspector の自動スキャンタイプ
- Amazon Inspectorの料金
投稿者プロフィール
-
2017年新卒入社。
入社当時からAWSを用いた開発をしています。
その中でも、サーバーレス構成をメインにしたアーキテクチャ設計から構築・運用に従事しています。
新たに得た経験や技術を積極的に共有することを心がけています。